Le MTBF (temps moyen entre pannes) est l’un des indicateurs de fiabilité les plus simples à calculer pour un atelier CNC. Il n’est utile que si le chiffre repose sur des données d’atelier propres et sur une définition claire de la panne.
Pour un chef d’atelier, un gestionnaire de production ou un planificateur, il transforme des arrêts flous en une mesure concrète : combien d’heures une machine tient en moyenne avant de s’arrêter. Bien utilisé, il permet de planifier la capacité sans gonfler chaque horaire « au cas où ».
Ce guide explique comment calculer le MTBF à partir de vos données de production et de maintenance, comment éviter les erreurs les plus courantes et comment utiliser le résultat au quotidien.
En bref :
-
Définissez ce qu’est une « panne » avant de toucher aux données, sinon le MTBF ne voudra rien dire d’une équipe, d’une machine ou d’une commande à l’autre.
-
Divisez le temps de fonctionnement observé par le nombre de pannes, laissez les arrêts planifiés hors du temps de fonctionnement et comptez une seule fois un arrêt qui déclenche plusieurs alarmes.
-
Le MTBF n’est qu’une donnée parmi d’autres : associez-le au MTTR, aux motifs d’arrêt et à l’avis des planificateurs avant de modifier un calendrier de maintenance.
Qu’est-ce que le temps moyen entre pannes (MTBF) et pourquoi c’est utile en atelier CNC
Pour une machine réparable comme une fraiseuse ou un tour CNC, le MTBF estime le temps de fonctionnement moyen entre une panne et la suivante. On le trouve aussi sous le nom de « moyenne des temps de bon fonctionnement ».
Le MTBF est directement utile dans les ateliers de petite et moyenne taille, où une seule machine hors service peut faire dérailler la journée. Un planificateur qui connaît le MTBF historique d’une machine prend de meilleures décisions : où placer une commande urgente, quelle marge laisser dans la semaine, quand prévoir une inspection.
Utilité pour la planification de la production
En pratique, le MTBF aide à répondre à des questions comme celles-ci :
-
À quelle fréquence cette machine tombe-t-elle en panne pendant la production ?
-
Quelles machines peuvent porter les commandes les plus prioritaires en toute confiance ?
-
Quelles machines faut-il inspecter avant une fin de semaine ou un quart de travail en heures supplémentaires ?
-
Quelle part d’arrêts imprévus faut-il prévoir dans un horaire réaliste ?
Il sert aussi à planifier les pièces de rechange. Prenons une panne de broche qui revient toutes les quelques centaines d’heures sur une machine, alors qu’une autre tombe rarement en panne. La politique de stock ne devrait pas être la même pour les deux. Le MTBF ne dit pas à lui seul quoi acheter, mais il donne un point de départ pour les points de commande et les revues de maintenance.
Lien avec le débit et la charge des opérateurs
Il y a aussi un effet sur le personnel. Les pannes fréquentes et courtes provoquent des interruptions pour les opérateurs, des appels aux superviseurs, des retards de réglage et des réorganisations de l’horaire. Ce travail caché compte. Pour ne pas confondre problèmes de fiabilité et manque d’efficacité de la main-d’œuvre, vous pouvez compléter avec le diagnostic de la charge opérateur.
Le MTBF se lit à côté d’autres indicateurs de fiabilité. Le MTTR (temps moyen de réparation) indique combien de temps dure le retour en production. Le taux de défaillance indique à quelle fréquence les pannes surviennent, par heure ou par cycle. Et le TRS donne une vue plus large des pertes de disponibilité.
Un atelier qui ne suit que le MTBF peut passer à côté d’un problème de taille : une machine qui tombe rarement en panne, mais qui met très longtemps à redémarrer. Le MTBF reste un indicateur de fiabilité courant, mais il a toujours besoin du contexte de la machine et des conditions mesurées.
Obtenez les données de pannes dont le MTBF a besoin
JITbase enregistre les motifs d’arrêt à la machine : les pannes et les arrêts planifiés sont séparés dès le départ.
Étape par étape : comment calculer le MTBF à partir des données d’atelier
Le calcul du MTBF est simple. Le plus difficile est de décider quelles heures et quelles pannes entrent dans le décompte. Commencez par la formule, puis précisez ce qui compte comme une panne.
La formule de base du MTBF
MTBF (temps moyen entre pannes) = temps de fonctionnement total observé / nombre de pannes
Pour une machine CNC, le « temps de fonctionnement » correspond généralement au temps où la machine était disponible pour produire et réellement en service pendant la période observée. Certains ateliers ne comptent que le temps de marche. D’autres prennent le temps de production disponible moins les arrêts planifiés. L’important est d’appliquer la même règle à toutes les machines et à toutes les périodes.
Si une machine a fonctionné 400 heures observées et subi 4 pannes admissibles, son MTBF est de 100 heures de fonctionnement. Autrement dit, la machine est tombée en panne une fois toutes les 100 heures de production en moyenne, pendant la période étudiée.
Pour voir comment une meilleure qualité des événements améliore ce calcul, vous pouvez consulter les méthodes de détection automatisée des arrêts, surtout quand la saisie manuelle des arrêts est inégale.
Qu’est-ce qui compte comme une panne ?
Avant de compter quoi que ce soit, écrivez ce qu’est une panne dans votre atelier. Une règle simple convient à la plupart des ateliers CNC :
-
À compter : les arrêts imprévus qui sortent la machine de la production, comme un défaut de broche, une panne de pompe de liquide de refroidissement ou un défaut du verrouillage de porte.
-
À ne pas compter : les réglages, les pauses, la maintenance planifiée et les changements de série prévus.
-
À compter une seule fois : un arrêt réel peut déclencher plusieurs alarmes en quelques secondes, mais il reste une seule panne.
Quelle que soit la règle choisie, appliquez-la à toutes les machines et à toutes les équipes. Des définitions différentes rendent le chiffre inutilisable.
Exemple chiffré avec des nombres simples
Voici un exemple illustratif. La fraiseuse 1 a fonctionné en quatre périodes sur deux jours :
-
Jour 1, matin : 4 heures de production, puis une panne (25 minutes)
-
Jour 1, après-midi : 4 heures de production
-
Jour 2, matin : 3 heures de production, puis une panne (40 minutes)
-
Jour 2, après-midi : 5 heures de production
Le temps de fonctionnement total est de 4 + 4 + 3 + 5 = 16 heures, pour 2 pannes. Donc :
MTBF = 16 / 2 = 8 heures de fonctionnement
Les 25 et 40 minutes de réparation ne font pas partie du temps de fonctionnement. Elles relèvent du MTTR, qui mesure la durée du retour en production. Et 8 heures ne veut pas dire que la prochaine panne surviendra exactement dans 8 heures : c’est une moyenne fondée sur des observations passées, sur la période choisie.
Les machines sans panne pour l’instant
Supposons maintenant que la fraiseuse 2 a fonctionné 30 heures pendant la même semaine sans aucune panne. Ses données comptent quand même : elles montrent que la machine peut fonctionner sans tomber en panne, même s’il n’y a aucun intervalle de panne complet sur la période. Beaucoup d’ateliers présentent un MTBF simple tout en signalant le petit nombre de pannes observées. Le premier gain consiste simplement à cesser d’ignorer le temps de fonctionnement des machines qui n’ont pas encore connu de panne.
En regroupant les deux machines, on obtient (16 + 30) / 2 = 23 heures de fonctionnement par panne pour le groupe. C’est un MTBF de groupe, qui ne décrit aucune des deux machines prise seule : la fraiseuse 1 doit donc rester présentée à part, à 8 heures.
Comment JITbase fournit les données du MTBF
Tout ce qui précède peut se faire dans un tableur, et beaucoup d’ateliers commencent ainsi. Le point faible, ce sont les données : des motifs d’arrêt saisis après coup, des alarmes en double, des arrêts planifiés mélangés aux vraies pannes. JITbase est conçu pour réduire cette étape manuelle.
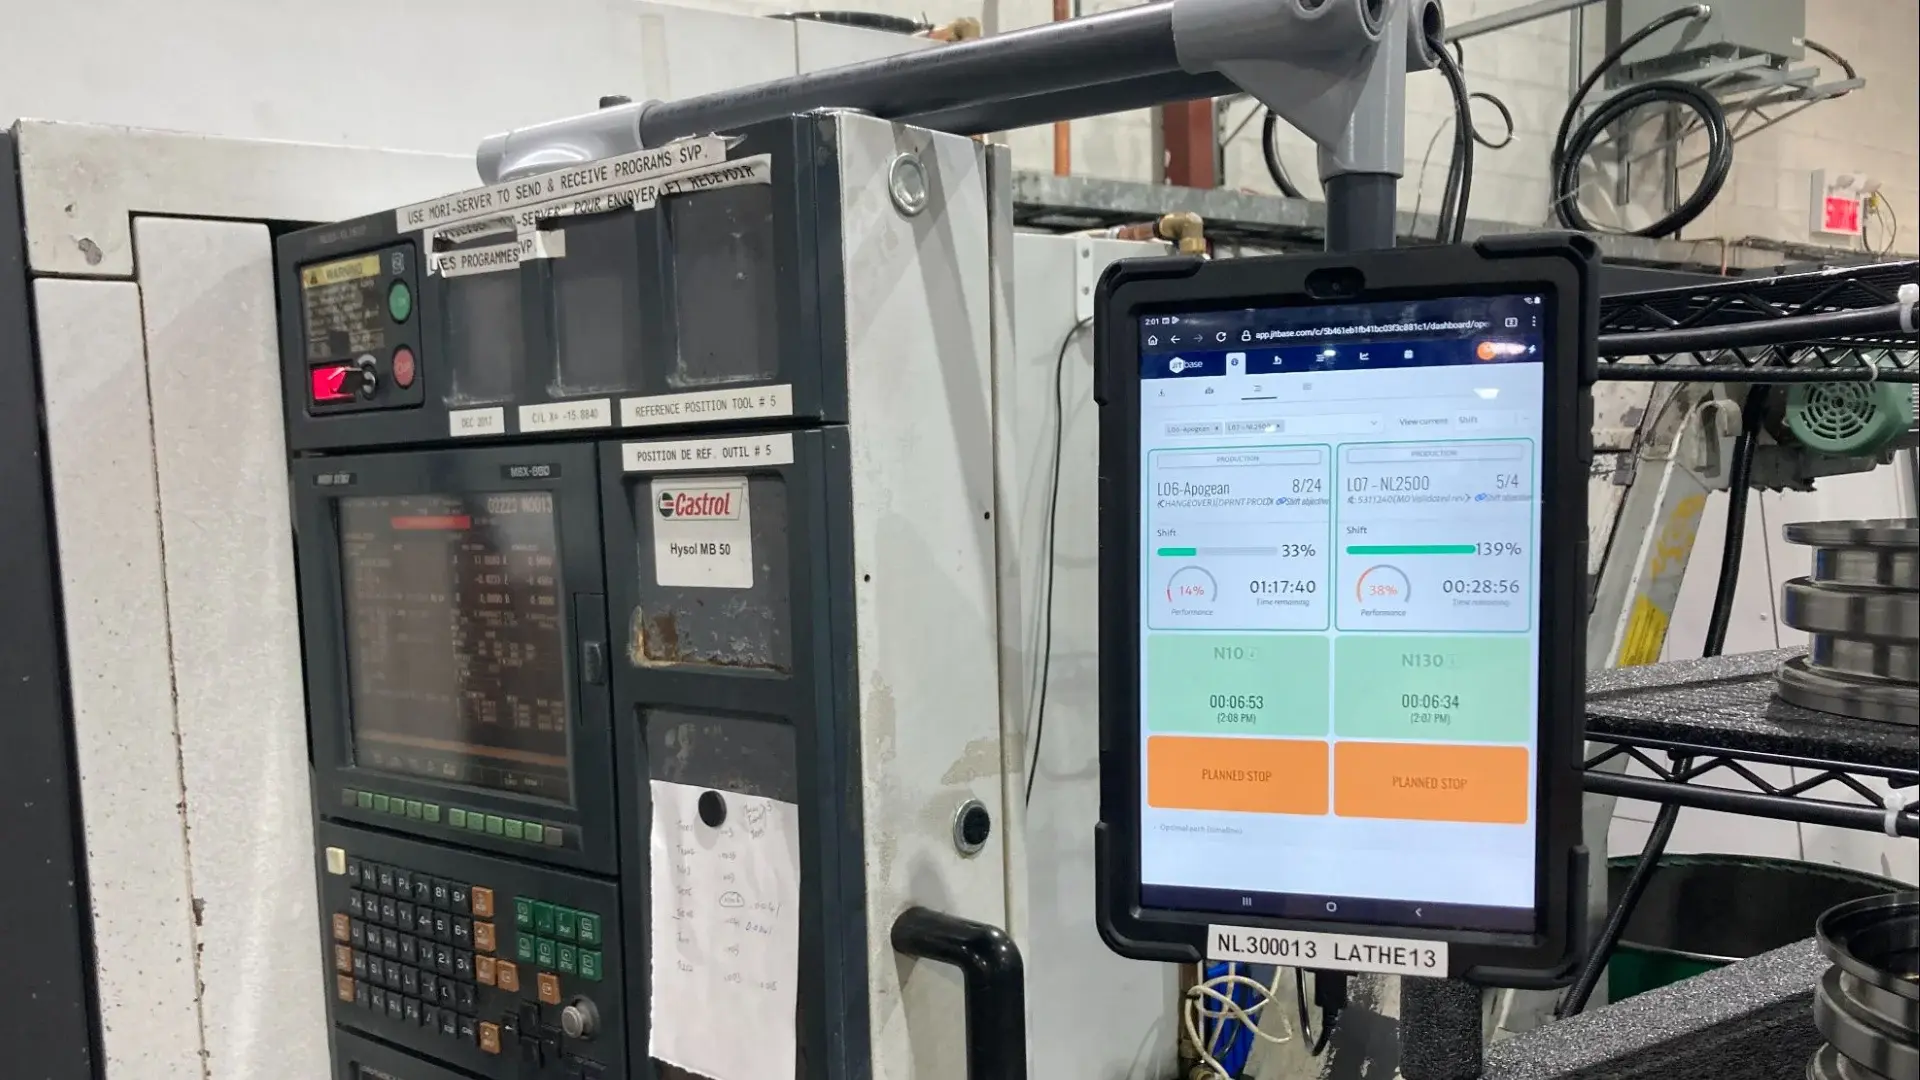
À l’écran de la machine, les opérateurs enregistrent le motif des arrêts. Le système sait ainsi si un arrêt est une panne ou un arrêt planifié (réglage, pause, changement de série). Vous obtenez un historique des arrêts qui sépare déjà les pannes des arrêts planifiés, avec le temps de fonctionnement de chaque machine à côté. Ce sont les deux données dont la formule du MTBF a besoin, et le calcul lui-même prend ensuite quelques minutes dans un tableur.
Deux avantages pratiques en découlent :
-
Des définitions constantes : les motifs d’arrêt sont enregistrés au moment où l’arrêt se produit, donc une panne veut dire la même chose à chaque équipe, au lieu d’être reconstituée plus tard.
-
Moins de reconstitution manuelle : les données nécessaires au MTBF sont déjà collectées, il y a beaucoup moins à recopier dans un tableur avant chaque revue de maintenance.
Pour voir comment les arrêts sont enregistrés, consultez le suivi machine. Le guide sur l’analyse des causes racines des arrêts montre quoi faire des arrêts une fois qu’ils sont classés.
Voyez les données derrière le MTBF sur vos propres machines
Réservez une courte démo pour voir comment les arrêts sont enregistrés à la machine et comment ces données alimentent le MTBF et d’autres indicateurs de fiabilité.
Quelles sources de données d’atelier contiennent les événements dont vous avez besoin
Une fois la formule connue, le vrai travail consiste à obtenir des données propres. Il vous faut au minimum un horodatage, un identifiant de machine, un type d’événement ou un état de la machine, et une fiche d’arrêt qui explique ce qui s’est passé.
La plupart des ateliers CNC possèdent déjà une partie des données nécessaires au temps moyen entre pannes. Le défi, c’est qu’elles se trouvent souvent à plusieurs endroits et à des niveaux de détail différents.
Journaux d’événements des machines et sorties d’automates
Les journaux de la commande CNC, les événements des automates programmables (API) et les signaux d’état de la machine constituent généralement la meilleure source d’horodatages. On y trouve des codes d’alarme, des événements de démarrage et d’arrêt, des arrêts d’avance, des fins de cycle, des états « machine prête », des défauts d’asservissement et des arrêts d’urgence. Ces flux d’événements à haute fréquence sont précis, mais bruyants : un seul problème électrique peut générer plusieurs événements en quelques secondes.
Champs utiles à saisir :
-
Horodatage
-
Identifiant de machine
-
Code d’événement ou d’alarme
-
Type d’événement
-
Durée, si elle est disponible
-
Identifiant de la commande ou de la pièce
-
Équipe ou contexte de l’opérateur
Pour les totaux de temps de fonctionnement, les données de programme et de cycle comptent aussi. Les ateliers qui cherchent à extraire des temps de cycle précis peuvent améliorer la partie « heures de marche » de l’équation du MTBF. C’est utile surtout quand les journaux bruts ne distinguent pas clairement le temps de coupe du temps d’attente.
Dossiers de maintenance et ordres de travail
Les dossiers de maintenance racontent l’autre moitié de l’histoire. Ils indiquent ce qui est réellement tombé en panne, ce qui a été réparé et combien de temps la machine est restée à l’arrêt. Ils précisent aussi si l’événement était mécanique, électrique, lié à l’outillage ou lié au procédé. Une alarme de la commande seule ne permet pas toujours de savoir s’il s’agissait d’un capteur défectueux, d’un porte-outil usé ou d’une collision causée par l’opérateur.
Rapports d’opérateurs et fiches d’arrêt manuelles
Les fiches d’arrêt manuelles sont moins précises, mais elles contiennent souvent les meilleures informations sur la cause. Les opérateurs peuvent noter « pompe de liquide de refroidissement en panne » ou « défaut du verrouillage de porte ». Cela facilite beaucoup la classification par la suite. Le compromis, c’est la constance : une équipe écrit « alarme », une autre « maintenance », et une troisième n’écrit rien.
Capteurs et flux d’état de l’IIoT
Des capteurs peu coûteux et des collecteurs IIoT (des capteurs reliés au réseau) peuvent améliorer la détection des événements quand l’accès à la commande est limité. Ils peuvent capter l’état d’alimentation de la machine, les variations de charge de la broche, les signaux de cycle ou l’état de la colonne lumineuse. Mais ces signaux doivent être validés : un voyant rouge peut signaler une vraie panne ou simplement un arrêt planifié.
C’est pourquoi beaucoup d’ateliers réalisent un court projet pilote et comparent la saisie automatique avec les notes des opérateurs ou les dossiers de maintenance.
Préparer et nettoyer les données d’atelier avant de calculer le MTBF
De mauvaises données produisent un MTBF qui a l’air propre, mais qui trompe. La préparation des données n’est donc pas une corvée : c’est le calcul.
Uniformiser les horodatages et les fuseaux horaires
Commencez par convertir tous les horodatages dans un seul fuseau horaire et un seul format. Cela semble élémentaire, mais des horloges de commande désynchronisées, les changements d’heure et des entrées de maintenance saisies après coup peuvent brouiller l’ordre des événements. Uniformisez aussi les identifiants de machines : « VF2 », « VF-2 » et « Fraiseuse 3 » ne doivent pas être traités comme des équipements différents s’il s’agit de la même machine.
Classer les pannes et compter chaque arrêt une seule fois
Ensuite, définissez une liste de types de pannes. Certains ateliers ne retiennent que les défauts d’origine machine, d’autres y ajoutent les bris d’outil qui arrêtent la production. Les deux choix peuvent fonctionner, à condition que la règle reste la même. Fusionnez ensuite les événements groupés : si un seul problème de variateur de broche produit cinq lignes d’alarme en 20 secondes, comptez une seule panne, pas cinq.
Les arrêts planifiés doivent en général être exclus à la fois du nombre de pannes et du temps de fonctionnement total, si l’objectif est de mesurer la fiabilité de l’équipement. Cela comprend la maintenance préventive planifiée, les réglages prévus et les fenêtres de changement de série connues, sauf si l’atelier applique une autre norme interne.
Données manquantes et machines sans panne pour l’instant
Des codes de motif manquants n’empêchent pas toujours l’analyse. L’atelier peut calculer le MTBF à partir des heures de fonctionnement et des pannes confirmées, puis améliorer la classification plus tard. Des horodatages manquants sont plus graves, car ils faussent les bornes des événements.
Beaucoup de petits ateliers oublient les machines qui n’ont pas encore connu de panne. Une machine qui a fonctionné toute la période sans panne fournit quand même du temps de fonctionnement utile : ne l’écartez pas. Marquez clairement ces enregistrements pour qu’on ne les confonde pas avec des données manquantes. Si l’atelier veut un traitement statistique plus poussé plus tard, un ingénieur en fiabilité peut l’aider, mais un jeu de données bien étiqueté est la première étape.
Comment utiliser le MTBF en maintenance et en planification de la production
Une fois le chiffre calculé, la vraie question est ce qu’on en fait. Une moyenne brute ne corrigera pas l’horaire si elle ne change aucune décision.
Traduire le MTBF en intervalles d’inspection ou de maintenance préventive
Un MTBF faible ou en baisse peut déclencher une revue d’inspection. Si une machine présente des arrêts électriques répétés toutes les quelques dizaines d’heures de fonctionnement, une inspection ciblée peut se justifier avant une autre grosse série de production. Mais ne fixez pas les intervalles de maintenance préventive à partir du seul MTBF.
Comparez le résultat avec les modes de panne réels, les recommandations du fabricant et les notes des techniciens. Les ateliers testent souvent un nouvel intervalle sur une machine ou un sous-système avant de modifier tout le plan de maintenance préventive.
Dimensionner les pièces de rechange et fixer les points de commande
La politique de pièces de rechange est une autre application pratique. Si les mêmes capteurs, pompes, relais ou connecteurs reviennent dans les pannes, les tendances du MTBF peuvent appuyer une décision de stock. Le chiffre a toutefois besoin du détail par catégorie de panne : un MTBF unique, qui mélange tous les modes de panne, ne suffit pas pour décider quelles pièces garder.
Communiquer les résultats aux planificateurs
Les planificateurs ont besoin d’un message de planification, pas d’un exposé sur la fiabilité. Par exemple : « La machine A tombe en panne deux fois plus souvent que la machine B depuis le dernier trimestre, et elle met aussi plus de temps à redémarrer. » Cela peut influencer l’acheminement des commandes, le risque en heures supplémentaires et le choix des commandes à éviter sur une machine fragile.
Si un atelier veut relier ses données CNC à l’ERP, le MTBF et les données d’arrêt peuvent alimenter les revues de planification. Ils servent aussi aux discussions sur les pièces de rechange et aux réunions hebdomadaires de capacité.
Limites et pièges courants du MTBF sur des machines CNC
Le MTBF est utile. Il est aussi facile à mal utiliser.
Quand le MTBF peut induire en erreur
D’abord, des modes de panne mélangés peuvent cacher le vrai problème. Une machine qui a des défauts de broche rares mais graves et des déclenchements fréquents de capteurs sans gravité affichera un seul MTBF mélangé, alors que la réponse de maintenance devrait être complètement différente. Ensuite, l’âge de l’équipement compte : les composants neufs peuvent connaître des pannes précoces, tandis que les machines plus anciennes peuvent glisser vers l’usure. Une moyenne unique sur les deux périodes peut brouiller le portrait.
Les petits échantillons sont un autre piège. Une seule panne sur un mois court ne permet pas de conclure, et un mois sans panne ne prouve pas que la machine est « réparée ». Les ateliers ne s’entendent pas non plus toujours sur ce qu’est une panne. Un outil brisé est-il un événement de fiabilité ? Et un défaut de palpeur causé par un mauvais montage ? Des équipes raisonnables peuvent définir cela différemment, mais elles ne doivent pas mélanger les définitions dans un même indicateur.
Indicateurs complémentaires (MTTR, taux de défaillance)
Le MTTR ajoute la durée de réparation. Le taux de défaillance indique la fréquence des événements par heure ou par cycle. La disponibilité combine le temps de fonctionnement et l’effet des réparations. Certaines équipes de fiabilité tracent aussi l’évolution de la probabilité de panne dans le temps, plutôt que de tout résumer par une seule moyenne.
Cette vue plus large explique pourquoi beaucoup d’ateliers présentent le MTBF à côté des minutes d’arrêt, du nombre de pannes par catégorie et de l’évolution du TRS sur le même écran. Un ensemble d’indicateurs donne de meilleures décisions qu’un chiffre unique. Les ateliers qui mettent en place un tableau de bord du TRS en temps réel constatent souvent un effet : les indicateurs de fiabilité prennent plus de sens quand opérateurs et planificateurs les voient ensemble.
MTBF et MTTR : tableau comparatif des indicateurs de fiabilité
Le MTBF et le MTTR répondent à des questions différentes. Le MTBF indique à quelle fréquence une machine tombe en panne, et le MTTR indique combien de temps il faut pour la remettre en marche. Les lire ensemble permet de savoir si le problème vient de pannes fréquentes, de réparations lentes, ou des deux.
| Indicateur | Définition | Quand l’utiliser | Données requises | Limites |
|---|---|---|---|---|
| MTBF | Temps de fonctionnement moyen entre deux pannes, pour un équipement réparable | Machines réparables qui tombent en panne à répétition | Identifiant de machine, temps de fonctionnement, nombre de pannes, horodatages | Masque les différences entre modes de panne, sensible à la taille de l’échantillon |
| MTTR | Temps moyen pour rétablir la fonction après une panne | Efficacité de la maintenance, rattrapage de l’horaire | Début de la panne, fin de la réparation, identifiant de machine, ordre de travail | Ne dit rien sur la fréquence des pannes |
| MTTF | Temps moyen avant panne, souvent utilisé pour les éléments non réparables | Consommables ou composants remplacés plutôt que réparés | Début de service, moment de la panne, identifiant du composant | Peu adapté aux machines CNC réparables |
| Taux de défaillance | Nombre de pannes par unité de temps ou par cycle | Comparer directement la fréquence des événements | Nombre de pannes, temps d’exposition ou cycles | Moins intuitif pour beaucoup d’utilisateurs en atelier |
| Disponibilité | Part du temps où l’équipement peut remplir sa fonction | Planification de la production, suivi du temps de marche | Temps de marche, temps d’arrêt, MTBF, MTTR, horaires | Peut masquer la cause des pertes |
Des méthodes simples et peu coûteuses pour collecter des données prêtes pour le MTBF
Un atelier n’a pas besoin d’un gros projet logiciel pour commencer à collecter des données de fiabilité exploitables. La première version peut être très simple.
Matériel minimal et procédures manuelles qui fonctionnent
Une installation peu coûteuse comprend souvent un journal quotidien par machine, des codes de motif de panne cohérents, des fiches d’arrêt remplies par les opérateurs et un cumul hebdomadaire dans un tableur. Des vérifications à chaque heure peuvent suffire si l’horodatage automatique n’est pas disponible, mais elles sont moins précises pour les arrêts courts. L’objectif principal est la constance : mêmes noms de machines, mêmes catégories d’arrêt, même base de temps.
Pour un point de départ pratique, consultez la façon de mettre en place le suivi du temps de cycle avec un minimum de matériel. La même discipline d’horodatage sert au MTBF.
Passer à l’échelle : détection automatique des événements
L’étape suivante consiste généralement à exporter les journaux de la commande, à surveiller de simples signaux d’entrée-sortie ou à utiliser un petit collecteur de données pour capter l’état marche/arrêt. La classification manuelle garde son importance, mais des horodatages automatiques réduisent les approximations. Certains ateliers cherchent aussi à automatiser la collecte des données entre les machines et l’ERP/MES, pour que les données ne dépendent pas de quelqu’un qui pense à taper une note après une panne stressante.
Si les données doivent aller vers des systèmes de planification ou de maintenance, commencez par un projet pilote sur une famille de machines. Validez d’abord l’exactitude des événements, puis associez les champs aux ordres de fabrication, aux identifiants d’équipement et aux rapports des planificateurs.
Liste de vérification de l’état de préparation des données
Avant de calculer le MTBF pour tout l’atelier, confirmez ces points de base :
-
Format d’horodatage cohérent entre les sources
-
Identifiants de machine uniques
-
Définition claire de la panne
-
Arrêts planifiés enregistrés séparément
-
Alarmes en double regroupées en un seul incident
-
Période d’observation assez longue pour inclure un temps de fonctionnement significatif
-
Dossiers de maintenance liés aux événements de la machine quand c’est possible
Commencez par un groupe de machines
Choisissez un groupe pilote, enregistrez les pannes pendant quelques semaines et passez en revue le premier MTBF avec votre équipe de maintenance.
En résumé
Le MTBF est utile parce qu’il transforme la fiabilité des machines en un chiffre dont planificateurs et équipes de maintenance peuvent discuter. Il ne fonctionne toutefois que si l’atelier définit clairement la panne et mesure le temps de fonctionnement réel.
Commencez par un court examen de vos journaux actuels, faites un premier calcul sur un petit groupe de machines et passez le résultat en revue avec la maintenance avant de modifier un calendrier. Un bon processus de MTBF reste simple, constant, et associé au MTTR et aux motifs d’arrêt.
Foire aux questions
Quelle durée d’observation faut-il pour le MTBF d’une machine CNC ?
Cela dépend du taux d’utilisation de la machine et de la fréquence des pannes. La période doit être assez longue pour inclure un temps de fonctionnement significatif et plus que quelques pannes. Pour une machine de production très sollicitée, un mois peut donner un premier aperçu, alors qu’une machine moins utilisée peut demander un trimestre ou plus.
La règle la plus importante est la constance. Comparez les machines sur la même période, indiquez les heures de fonctionnement observées et le nombre de pannes à côté du MTBF, et évitez d’interpréter une courte période comme une tendance. Si une machine n’a connu qu’une seule panne sur la période, considérez le résultat comme un point de départ plutôt que comme une conclusion.
Quelle est la différence entre le MTBF et le MTTF ?
Le MTBF s’applique généralement aux équipements réparables, comme les machines CNC qui reviennent en service après une panne. Il mesure le temps de fonctionnement moyen entre une panne et la suivante. Le MTTF (temps moyen avant panne) sert plutôt pour les éléments non réparables ou les composants remplacés plutôt que réparés.
En atelier, un relais de variateur de broche que l’on remplace quand il tombe en panne peut être suivi avec le MTTF, alors que la machine entière est suivie avec le MTBF. Utiliser le bon terme est important quand on compare des chiffres venant de fournisseurs, de logiciels de maintenance et de rapports internes, car ils ne mesurent pas toujours la même chose.
Quelle est la différence entre le MTBF et le MTTR ?
Le MTBF mesure la fréquence des pannes : le temps de fonctionnement moyen entre une panne et la suivante. Le MTTR (temps moyen de réparation) mesure le temps nécessaire pour remettre la machine en production après une panne. L’un décrit la fréquence, l’autre la durée du retour en production.
Les lire ensemble donne une image plus claire. Une machine avec un MTBF élevé mais un MTTR long tombe rarement en panne, mais coûte cher quand cela arrive, alors qu’une machine avec un MTBF faible et un MTTR court tombe souvent en panne mais redémarre vite. Chaque cas appelle une solution différente : pièces de rechange et compétences de réparation dans le premier cas, analyse des causes racines dans le second.
Faut-il inclure les arrêts planifiés dans le MTBF ?
En général, non. La maintenance planifiée, les réglages prévus, les pauses et les changements de série approuvés sont habituellement exclus, parce que le MTBF sert à décrire le comportement des pannes imprévues. Les compter comme des pannes ferait paraître une machine en bon état comme peu fiable.
Si un atelier choisit une autre règle, il doit l’appliquer de façon constante et la documenter pour que les comparaisons restent valables. Enregistrer les arrêts planifiés et imprévus sous des motifs distincts à la machine rend cela facile, car la distinction se fait au moment de l’arrêt plutôt que d’être reconstituée plus tard.
Que faire quand les données de pannes sont rares ?
Les données rares sont courantes, surtout pour les machines récentes ou peu utilisées. Continuez à accumuler le temps de fonctionnement, marquez clairement les périodes sans panne et évitez les conclusions fermes à partir d’un tout petit échantillon. Une machine qui n’a pas encore connu de panne fournit quand même des heures de fonctionnement au calcul.
Dans vos rapports, présentez le MTBF à côté du total des heures observées et du nombre de pannes, pour que les lecteurs jugent de la fiabilité du chiffre. Regrouper des machines semblables peut aider, à condition de bien indiquer que le chiffre est celui du groupe et de continuer à examiner chaque machine séparément.
Le MTBF peut-il à lui seul déterminer les calendriers de maintenance ?
Non. Le MTBF est une donnée parmi d’autres. Le calendrier de maintenance doit aussi tenir compte du mode de panne, du risque pour la sécurité, de la durée de réparation, des recommandations du fabricant, de la demande de production et du jugement des techniciens.
Un atelier qui modifie ses intervalles de maintenance préventive à partir d’une seule moyenne risque de corriger le mauvais problème ou de créer des arrêts inutiles. Une approche plus sûre consiste à tester un nouvel intervalle sur une machine ou un sous-système, puis à examiner quelques semaines de données de pannes avec l’équipe de maintenance avant de l’étendre.